Vor Kurzem habe ich geschrieben, dass KI-Firmen Miete für meine Inhalte zahlen sollten. Jeden Monat, für jede Website, die sie crawlen und weiter nutzen.
Am 30. Oktober haben OpenAI, Google, Microsoft und Anthropic etwas anderes angekündigt. Eine Zeile für die robots.txt, die ihnen sagt: Mit dieser Website bitte keine KI trainieren.
Von Geld ist keine Rede.
Das Signal
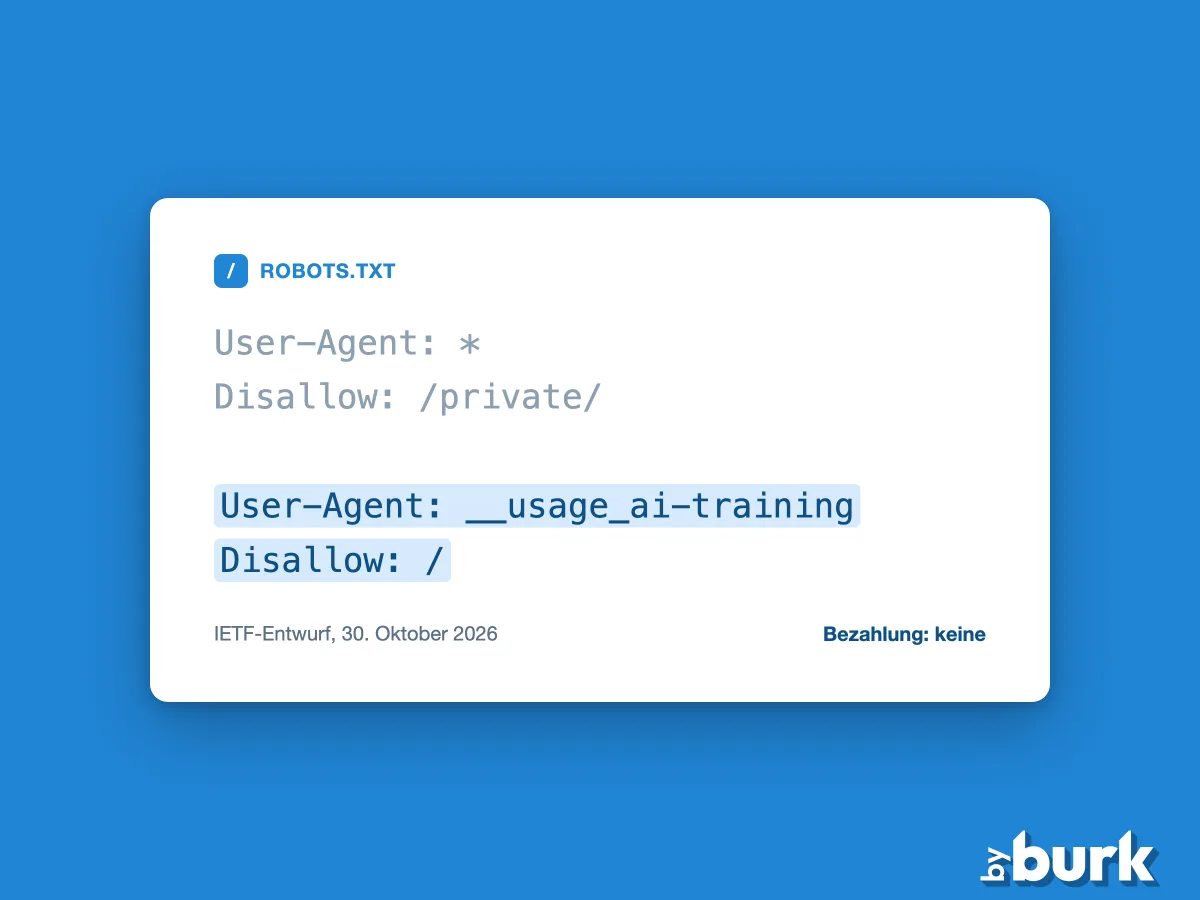
Die robots.txt ist die kleine Datei auf jeder Website, die Bots sagt, was sie crawlen dürfen. Der neue Eintrag sieht so aus:
User-Agent: __usage_ai-training
Disallow: /
Das heißt: Nichts auf dieser Website fürs KI-Training verwenden. Man kann auch einzelne Ordner freigeben, zum Beispiel einen Pressebereich.
Ein Detail übersieht man leicht. Die übliche Zeile User-Agent: * zählt nicht. Steht nur sie in der robots.txt, sagt die Datei nichts übers Training. Das neue Token muss ausdrücklich drinstehen.
Und es ist ein Wunsch. Bots dürfen die Seite weiter besuchen. Sie werden nur gebeten, mit dem Gefundenen nicht zu trainieren.
Außerdem ist es noch kein fertiger Standard. Es ist ein Entwurf bei der IETF, der Organisation hinter vielen Internetstandards. Eingereicht hat ihn jemand von Anthropic, am selben Tag. Die zuständige Arbeitsgruppe hat ihn nicht übernommen.
Wer mitmacht
Vier Firmen sagen, sie halten sich daran. Freiwillig. Niemand setzt das durch.
Microsoft nennt ein Datum: 1. Februar 2027. Google sagt Anfang 2027. OpenAI spricht von den kommenden Monaten. Anthropic sagt, es habe schon angefangen.
Meta sagt, es unterstütze, dass Verlage ihre Präferenzen äußern können. Ob Meta sich an dieses Signal hält, hat es nicht gesagt.
Apple, Perplexity, xAI, Mistral… noch keine Zusage. Zumindest habe ich keine gefunden.
Nur Training
Das Signal betrifft das Training. Nicht die Antworten.
In meinem Miete-Artikel waren die Antworten das größere Problem. Leute bekommen sie von der KI und klicken nie auf die Website, von der die Antwort stammt.
Googles KI-Übersichten und der KI-Modus sind vom neuen robots.txt-Signal nicht betroffen. Dafür gibt es eine eigene Einstellung in der Search Console. Microsoft trennt ebenfalls: eine Einstellung fürs Training, eine fürs „Grounding“, also wenn Copilot und Bing eine Seite nutzen, um eine Frage zu beantworten.
Beide Firmen sagen, ein Opt-out ändere nichts am normalen Ranking in der Suche.
Bei Google gibt es einen Haken, soweit ich das sehe. Wer mit dem neuen Signal widerspricht, blockiert damit Google-Extended. Und laut Google können Seiten, die Google-Extended zulassen, mit Klicks in Geminis Antworten auftauchen. Nein zum Training heißt also wahrscheinlich auch Nein zu diesen Klicks.
Die alten Regeln für die Bots der einzelnen Firmen bleiben ebenfalls. GPTBot, ClaudeBot, Google-Extended. Die Liste in der robots.txt wird nicht kürzer.
Geld
Keine der vier Firmen erwähnt eine Bezahlung. Microsoft sagt es deutlich: Die Einstellungen „do not establish licensing or payment arrangements“.
Der Entwurf sagt sogar, private Vereinbarungen können ihn aushebeln.
Und RSL, der Standard, mit dem eine Website einen Preis in die robots.txt schreiben kann? Den habe ich beim letzten Mal erwähnt. Keine der vier hat ihn jetzt erwähnt. Das RSL Collective führt keine KI-Firma, die darüber lizenziert, soweit ich sehe.
Am selben Tag hat OpenAI noch einen Beitrag veröffentlicht, Titel: „Fair use benefits everyone.“ Darin nennt OpenAI die Klage der New York Times die Jagd nach einem „undeserved payday“.
Macht daraus, was ihr wollt.
Nachteile
- Es ist ein Entwurf. Die Details können sich noch ändern, bevor daraus ein Standard wird. Falls einer daraus wird.
- Es ist freiwillig. Ein Bot, der es ignoriert, hat nichts zu befürchten.
- Es sind vier Firmen. Viele andere Crawler stehen nicht auf der Liste.
- Die KI-Antworten bleiben unberührt, und dorthin gehen die Klicks.
- Und bei Google kann es eine Website ihren Platz in Geminis Antworten kosten.
Unterm Strich
Jetzt gibt es also einen Weg, vier KI-Firmen Nein zu sagen. Meistens ab 2027.
Einen Weg, „Ja, für so viel“ zu sagen, gibt es immer noch nicht.
Zuerst auf Englisch erschienen: Medium